Perguntei a um amigo, pessoalmente, se havia alguma coisa no trabalho dele que ele gostaria que um software resolvesse. Ele trabalha numa empresa que vende pela Shopee, e parte do trabalho dele é imprimir as etiquetas de envio. Ele me falou das etiquetas saindo desalinhadas.
Cada pedido da Shopee sai em duas páginas: a etiqueta de envio e o checklist de carregamento, com os itens. A impressora fica configurada com "2 páginas por folha", então cada folha, uma etiqueta térmica 4×6, leva um pedido inteiro: etiqueta e checklist juntos. Isso funciona enquanto todo pedido tiver exatamente duas páginas.
Quando um pedido tem muitos itens, o checklist transborda para uma terceira página. O exemplo que ele me deu foi uma impressão de 101 páginas com um pedido nas páginas 89 a 91. Da página 92 em diante, toda etiqueta de envio saía colada no checklist do pedido anterior:
Antes: um pedido tem 3 páginas

folha 45 | p.89  etiqueta A         | p.90  checklist A   |
folha 46 | p.91  checklist A (2)    | p.92  etiqueta B    |  <- B começa na metade errada
folha 47 | p.93  checklist B        | p.94  etiqueta C    |
...e toda folha daqui para frente fica deslocada em uma página

Depois: uma página em branco logo depois do pedido ímpar

folha 45 | p.89  etiqueta A         | p.90  checklist A   |
folha 46 | p.91  checklist A (2)    | p.92  (em branco)   |
folha 47 | p.93  etiqueta B         | p.94  checklist B   |
A solução cabe numa frase: se um pedido tem número ímpar de páginas, coloque uma página em branco depois dele. Fazer isso à mão significava imprimir em partes, calcular as quebras por conta própria e torcer para não imprimir um pedido duas vezes.
Eu não sabia o que era um arquivo ZPL
A parte mais difícil do projeto inteiro foi entender o problema. Olhando agora, é simples. Na hora, sem conhecer o trabalho dele, a primeira explicação parecia ter muita coisa envolvida, e fui fazendo perguntas até enxergar o que precisava acontecer.
Eu também nunca tinha ouvido falar de ZPL. É a linguagem das impressoras de etiqueta da Zebra, e é o que a Shopee entrega quando você baixa as etiquetas. Tive que ir ler sobre isso antes de conseguir planejar qualquer coisa.
O que aprendi sobre o fluxo de trabalho: baixar os arquivos ZPL da Shopee, uns 300 por dia, converter em PDF num site gratuito, sem prévia e sem edição, e imprimir pelo navegador. Além do desalinhamento, duas coisas me incomodaram. O site gratuito recebe nome, endereço, CEP e produtos de todos os compradores. E nada impede que o mesmo pedido seja impresso duas vezes.
Sexta: escrever antes de programar
Na sexta, 25 de setembro, passei o dia escrevendo uma especificação: contexto, restrições, fases e critérios de aceite. O site gratuito não custa nada, então o preço nunca ia ser o argumento. O argumento é segurança dos dados, tempo, menos erro humano e menos papel, e escrevi que toda decisão de produto tinha que servir a esses quatro pontos.
As restrições: 100% offline, sem telemetria, respeitando a LGPD, sem pedir administrador para instalar nem para rodar, só dependências com licença permissiva (MIT, Apache, BSD, OFL), Windows 10 e 11, e interface em português.
A regra do alinhamento virou um invariante. Todo pedido ocupa um número par de páginas, então toda etiqueta de envio cai numa página ímpar. O critério de aceite foi o caso do meu amigo: a impressão de 101 páginas vira 102, com o branco na página 92 e a etiqueta seguinte na 93.
Meu primeiro palpite de stack entrou na especificação como palpite: .NET 8, WPF ou WinUI 3, uma biblioteca chamada BinaryKits.Zpl.Viewer para renderizar o ZPL e o PDFsharp para gerar o PDF. Cada escolha estava ali para ser confirmada ou descartada. Antes de qualquer trabalho de produto havia uma etapa zero, um spike de fidelidade: se os códigos de barras e os QR Codes da minha saída não pudessem ser lidos, eu parava ali.
Também decidi como ia trabalhar: planejar primeiro, arquitetura e marcos antes do código, um marco por vez com commits pequenos, e nada de uma fase futura antes de terminar a atual. Toda decisão que mudava a especificação virava uma linha numa tabela, com o motivo ao lado.
Sábado: a Shopee não manda o que eu achava
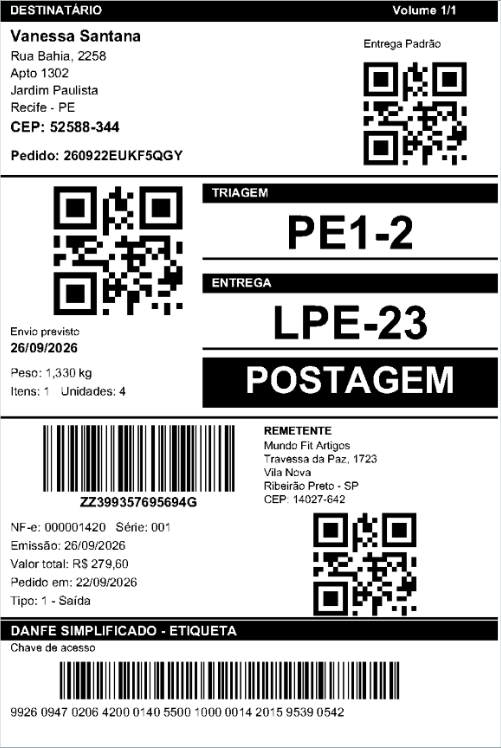
O spike foi o primeiro commit, às 15h22 de sábado. A especificação supunha um ZPL cheio de texto. Cada página, na verdade, é um único bitmap preto e branco de 816×1218 pontos (4×6 polegadas a 203 dpi), comprimido dentro do ZPL. Não tem texto nenhum. Nome, endereço, ID do pedido e produtos são todos pixels.
É assim que uma página fica, sem os dados da imagem:
~DGR:<nome>.GRF,124236,102,:Z64:<base64 dos dados zlib>:<crc16>
^XA^MMT,Y^PON^MNY^FO0,0^XGR:<nome>.GRF,1,1^FS^PQ1,0,0,N^XZ
^XA^IDR:<nome>.GRF^FS^XZ
A primeira linha carrega a imagem na memória da impressora, a segunda imprime e a terceira apaga. Tudo o que está na etiqueta é essa imagem:
Isso mudou quase todo o plano:
- Sem biblioteca para renderizar ZPL. Os arquivos da Shopee não têm nada para ela renderizar. Um interpretador próprio, com uma lista fechada de comandos ZPL, é exato por construção, e qualquer comando fora da lista reprova o arquivo em vez de gerar uma etiqueta errada em silêncio.
- Sem PDFsharp. A versão que testei gravava fluxos compactados sem o final do zlib (o
qpdf --checkreclamava), ligava a interpolação da imagem e colocava IDs aleatórios nos metadados, então a mesma entrada nunca gerava o mesmo PDF. O PDF de que eu precisava era só de imagens 1-bit, então virou um gerador próprio, usando a biblioteca padrão. - .NET 10 LTS no lugar do .NET 8, porque o suporte ao .NET 8 acaba em novembro de 2026.
- WPF no lugar do WinUI 3: é maduro, publica como um executável único sem MSIX e roda no Windows 10.
- O código de rastreio, lido no código de barras, virou a chave de cada pedido (duplicidade, histórico, busca), porque o ID do pedido só existe como imagem.
O spike também achou um problema no fluxo antigo. O site gratuito coloca o mesmo bitmap numa página de 100×150 mm, o que reduz a imagem para cerca de 98%. Só isso já deixa ilegível o código de barras de 44 dígitos da chave da NF-e:
| PDF do site gratuito | PDF do ExpedL | |
|---|---|---|
| Página | 100×150 mm, imagem a ~98% | 4×6 pol, imagem em 1:1 |
| Código de barras da NF-e legível | 0 de 50 | 50 de 50 |
| Todos os códigos lidos a 203, 300 e 600 dpi | 200 de 250 | 250 de 250 |
Nenhum dado real entrou no repositório. A especificação pedia uma ferramenta para anonimizar o texto dos arquivos ZPL, mas não havia texto para anonimizar, então essa ferramenta virou um gerador de páginas sintéticas no mesmo formato. Toda página de teste leva a marca SINTETICO, e um teste falha se a marca estiver faltando.
Sábado à noite: alinhar é fácil, imprimir não
O alinhamento é uma função pura que só enxerga números de página. O invariante "toda etiqueta em página ímpar" é testado em 500 combinações, e o gerador de PDF recusa uma sequência de páginas que o quebre.
Para alinhar, o app precisa saber qual página é etiqueta. Uma página conta como etiqueta se o código de barras do rastreio for legível ou se mais de 15% dela for tinta. Nos meus testes, as etiquetas ficaram entre 0,246 e 0,266 de tinta e os checklists entre 0,011 e 0,073. Quando os dois critérios discordam, o app não insere nenhum branco e mostra um aviso, em vez de chutar.
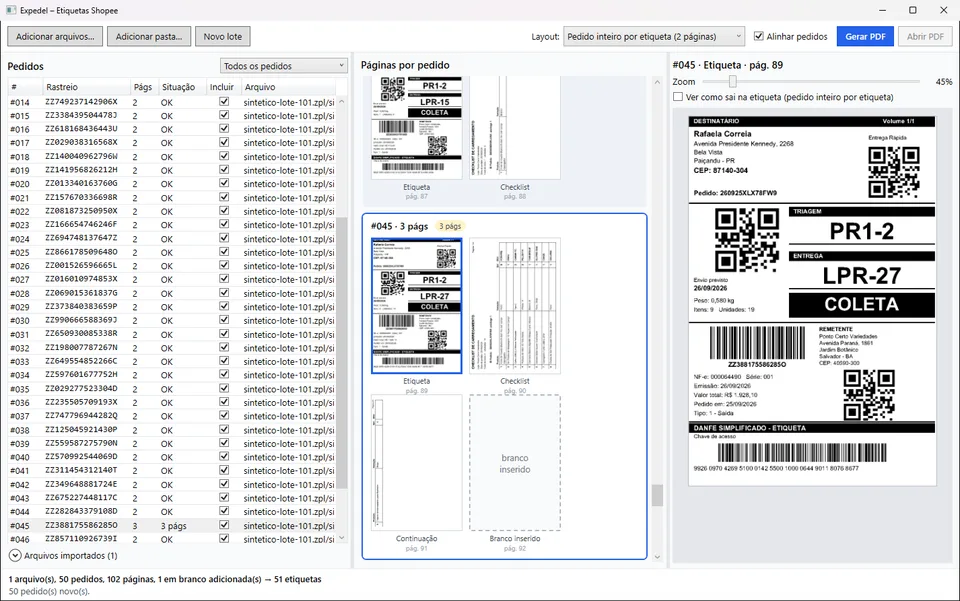
A primeira tela ficou pronta às 19h20. Num lote sintético de 101 páginas, o pedido #045 tem três páginas, da 89 à 91, e o app coloca o branco na página 92, como no exemplo do meu amigo:
A maior surpresa foi a impressão. A especificação tinha layouts em A4. Fazendo mais perguntas, vi que não havia A4 em lugar nenhum: só etiquetas térmicas 4×6, impressas pelo navegador com "2 páginas por folha" a 100%, com o navegador girando as duas páginas e reduzindo para 2/3. Então o app assumiu esse trabalho. Ele mesmo monta cada etiqueta 4×6 com o pedido inteiro, e quem imprime só manda a 100%, uma por folha, sem configurar nada. A mesma tela ganhou uma opção para ver como a etiqueta sai:
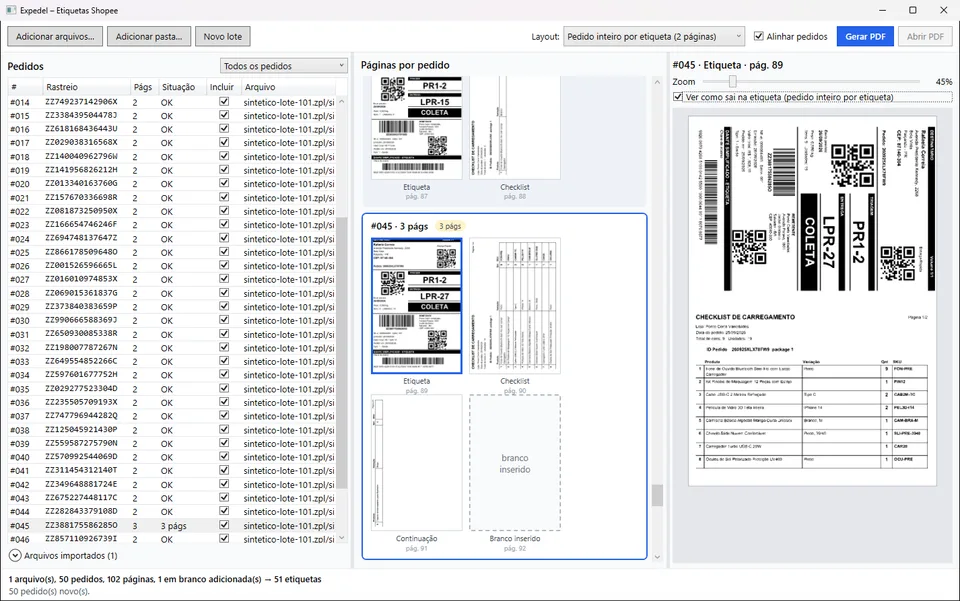
Isso criou um problema novo com os códigos de barras. Reduzir um código de barras para 2/3 numa impressora de 203 dpi não funciona: uma barra de 2 pontos vira 1,33, e a impressora só imprime 1 ou 2. Na bancada, 0 de 30 códigos Code 128 puderam ser lidos depois da redução. A saída foi reconstruir o padrão de cada Code 128 a partir da estrutura do código e redesenhá-lo com barras de largura inteira. O conteúdo não muda, só a largura das barras. Com isso, o código da NF-e continua legível na etiqueta montada, o que também não acontecia no fluxo antigo, pelo navegador.
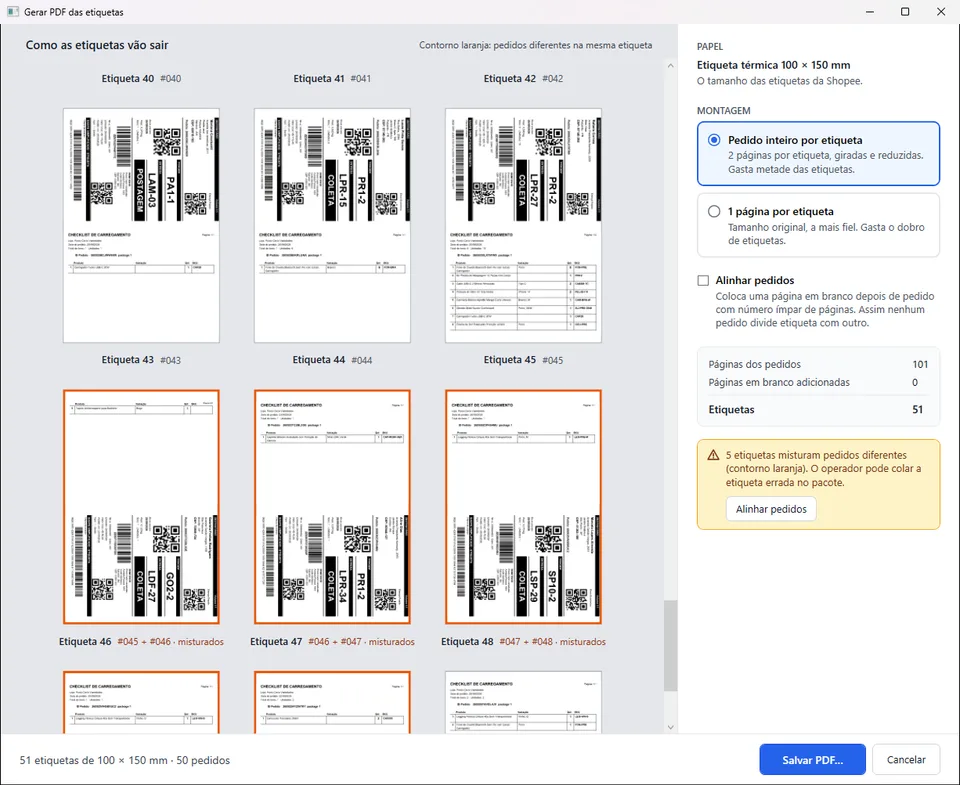
Às 22h20 já havia uma janela "Gerar PDF" que mostra todas as etiquetas antes de salvar. O mesmo lote, primeiro com o alinhamento desligado:
E com ele ligado:
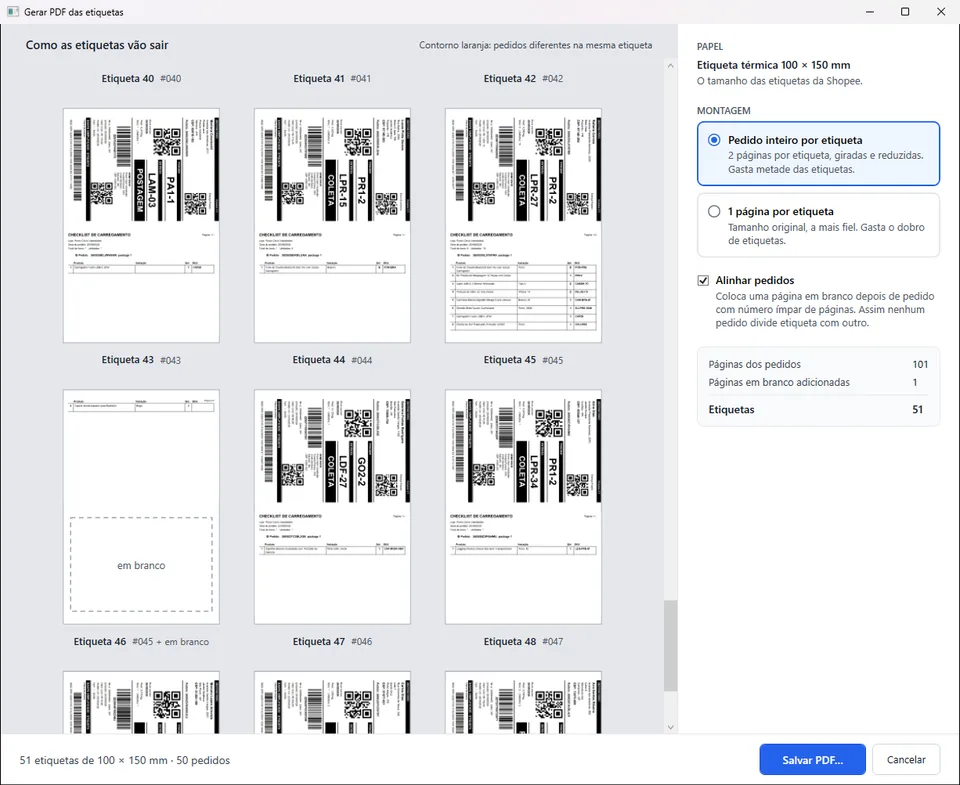
A essa altura, a primeira versão já lia os arquivos com segurança, com limites de tamanho, agrupava as páginas em pedidos, alinhava, gerava o PDF e mostrava tudo numa janela WPF. Com 300 arquivos (600 páginas), a tabela ficava completa cerca de 1,35 s depois de a janela abrir, e a janela respondia em menos de 30 ms enquanto trabalhava. O PDF de 102 páginas saía em 11 ms. Antes de a noite acabar, entraram o histórico dos pedidos já impressos (cifrado com DPAPI, guardado por 90 dias), a busca e reimpressão de um pedido e a edição do lote: arrastar, remover, brancos manuais e desfazer, com o alinhamento refeito a cada edição.
Domingo de manhã: ler o que é só pixel
Ordenar por produto, gerar uma lista de separação e buscar por SKU precisam de texto, e não havia texto. Então, antes de qualquer função que dependesse disso, mais um spike: OCR. Comparei o Tesseract com o OCR que já vem no Windows. O OCR do Windows achou no checklist o mesmo ID do pedido da etiqueta em 50 de 50 pedidos, em cerca de 95 ms por página, offline e sem dependência nova. O Tesseract traria DLLs nativas e uns 20 MB. O do Windows ganhou. Ele é chamado por uma ponte COM escrita à mão, porque o pacote oficial para acessá-lo não tinha licença permissiva.
Os códigos de roteamento foram um pequeno quebra-cabeça. A etiqueta tem duas caixas pretas com códigos, e a Shopee não documenta o que são. Medindo 50 etiquetas, deu para ver que a caixa de cima é o centro de triagem e a de baixo é a agência de entrega (L, a UF e um número, como em PR1-2 · LPR-18). O app agora lê cada caixa pela posição e corrige as confusões comuns do OCR (0 e O, 1 e I) pelo formato que cada caixa pode ter. Isso corrigiu todas as 10 leituras erradas do meu conjunto de teste.
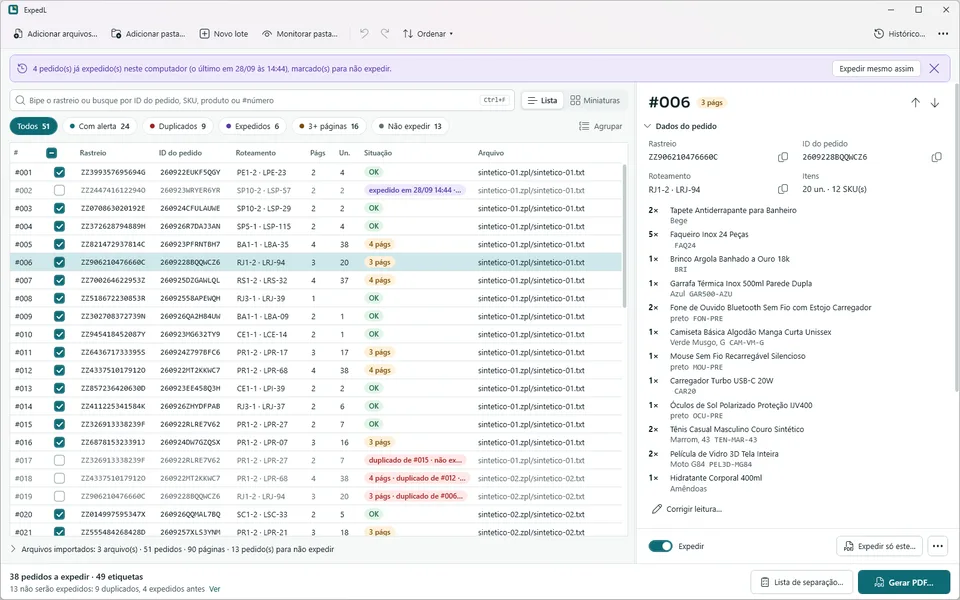
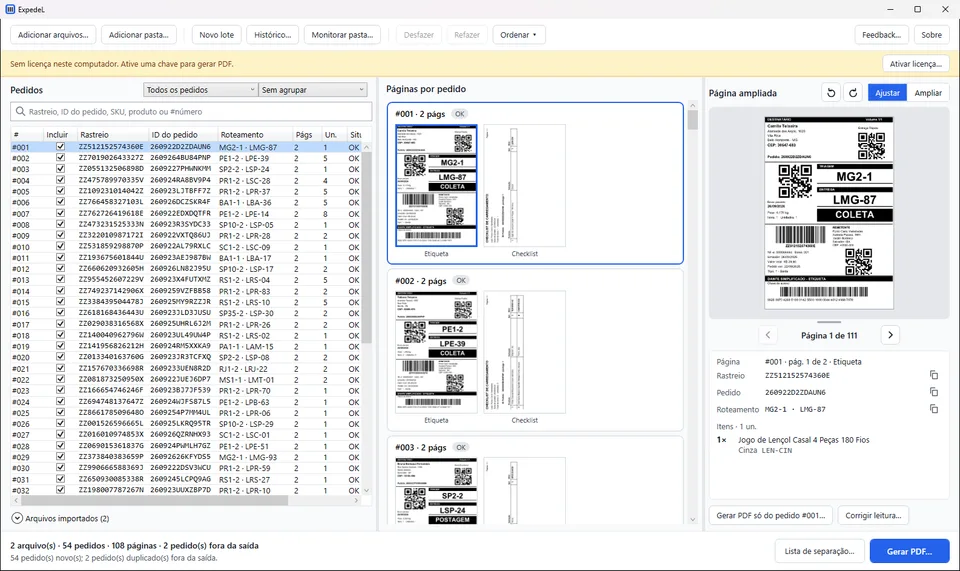
No domingo à tarde, a tabela já tinha as colunas de ID do pedido e roteamento, a busca aceitava rastreio, ID do pedido, SKU ou produto, e o painel lateral listava os itens lidos no checklist:
A lista de separação soma os itens do lote inteiro por SKU, para quem separa os produtos pegar tudo de uma vez. Ela só soma leituras idênticas e marca as quase iguais com "confira". Uma camiseta "AZUL P" e uma "AZUL M" estão a uma letra de distância e são tamanhos diferentes. Ver duas linhas do mesmo produto incomoda, mas separar o tamanho errado é pior.
O OCR também deixou o app pior por um tempo. O pico de memória foi de uns 510 MB para 1,1 GB, e a janela travava por até 1,7 s. O OCR começava junto com o desenho da lista, alocava uns 5 MB por página em 6 threads, e o garbage collector vivia parando a thread da interface. Depois de reaproveitar buffers, limitar o OCR a 4 threads e esperar a janela ficar ociosa antes de começar, o pico ficou em uns 685 MB e a maior pausa em uns 0,7 s.
Domingo à tarde: aprender a vender software
Eu nunca tinha vendido software, então essa parte foi pesquisa. Precisei decidir como seria a licença de um app que nunca se conecta à internet, e o que a lei exige de mim antes de um desconhecido poder instalá-lo.
A licença que escolhi é paga uma vez, vitalícia, com um ano de atualizações, e presa a um computador. Importar e conferir um lote são livres, para qualquer pessoa ver o que o app faz. Gerar o PDF pede uma chave. Na primeira tentativa, havia um teste automático de 15 dias, mas apagar duas marcas locais dava mais 15 dias. Emitir uma chave à mão me custa pouco, então troquei por chaves de teste que eu mesmo envio, com data de validade.
Deixei a assinatura de código de fora por enquanto. O certificado custa dinheiro e ainda não há clientes, então quem baixa o app vê o aviso do SmartScreen do Windows uma vez por versão.
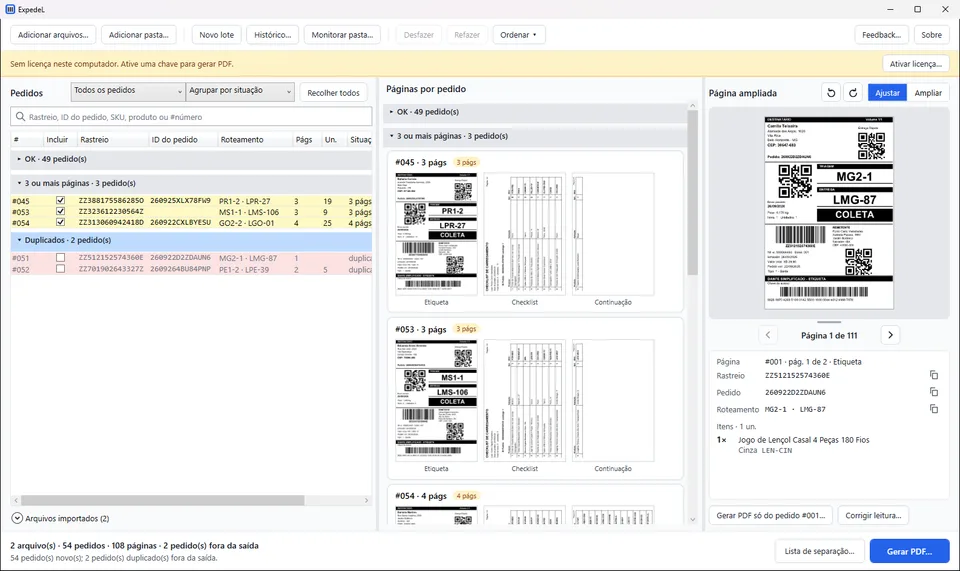
Depois fiz a minha própria lista de 15 melhorias, coisas que eu achava que deixariam o app mais útil no dia a dia. Uma eliminou um risco real: gerar o PDF duas vezes na mesma sessão imprimia tudo em dobro, sem aviso, e agora cada pedido é marcado como expedido assim que o PDF é salvo. Outra restaura o lote depois de uma queda, sem gravar nenhuma etiqueta em disco. Outras ajudam a achar as coisas num lote grande: agrupar a lista por arquivo ou por situação e corrigir à mão uma leitura do OCR. Agrupando por situação, os pedidos com três páginas ou mais e os duplicados ganham grupos próprios:
Domingo à noite: refazer a interface
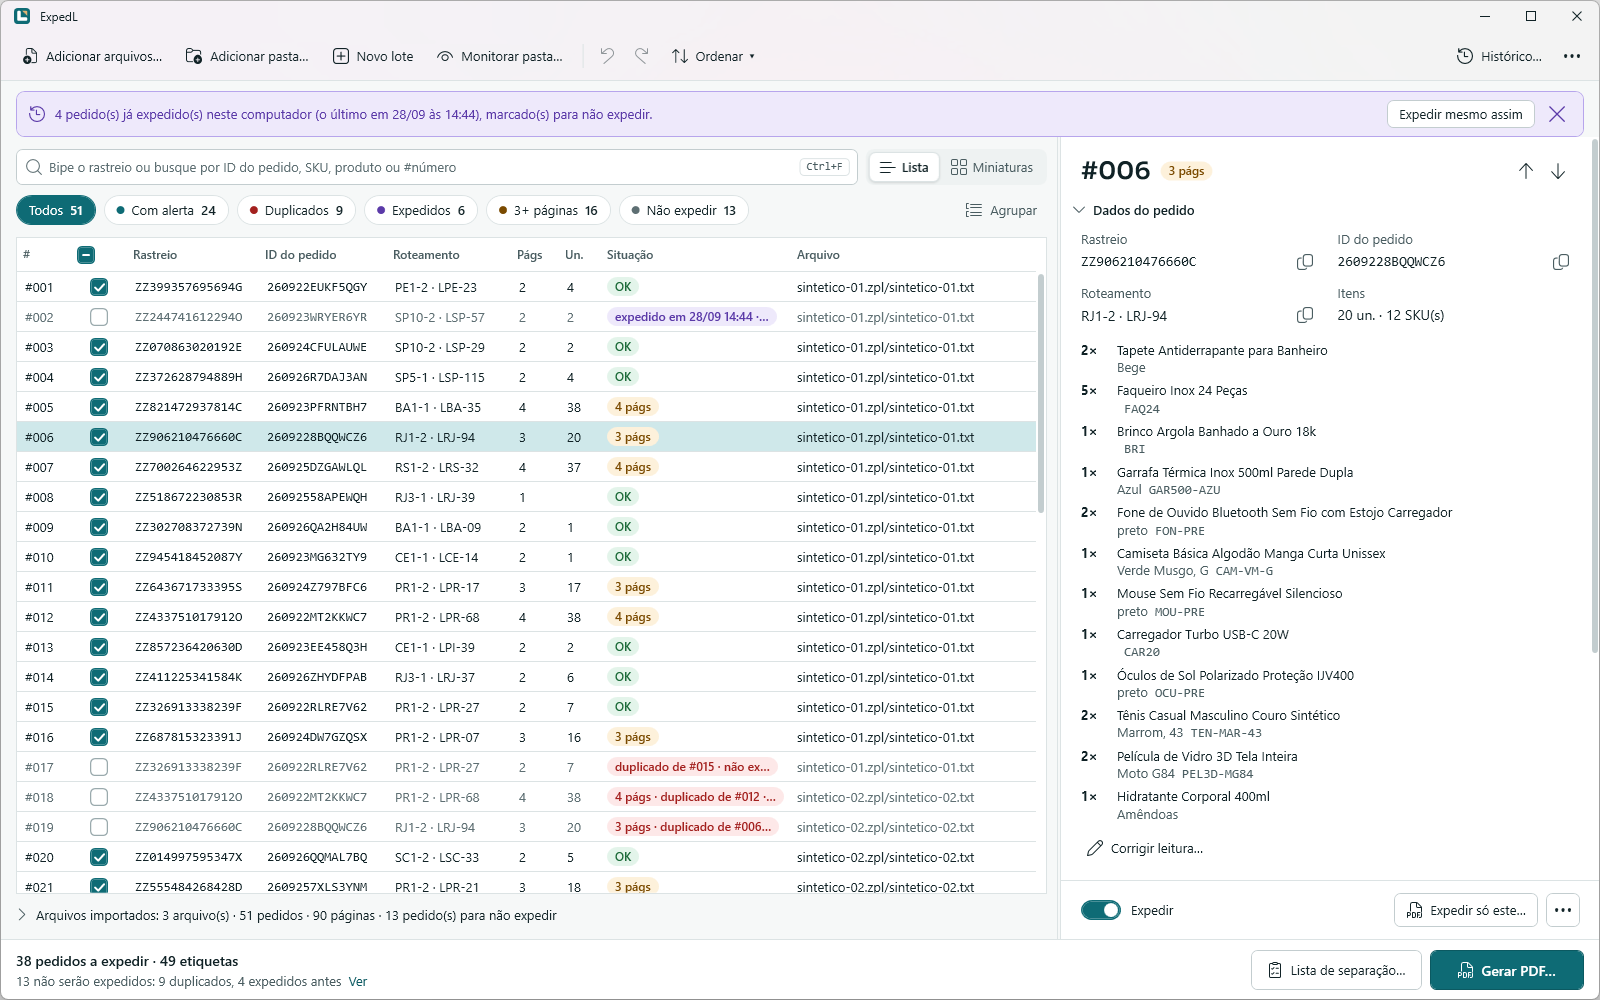
As duas últimas capturas mostram como estava a tela principal no fim da tarde de domingo. Ela mostrava o mesmo lote três vezes, como tabela, como cartões e como página ampliada, cada um com a sua rolagem. A repaginada transformou isso numa lista com um inspetor do pedido selecionado, e as contagens do lote viraram filtros clicáveis: pedidos com alerta, duplicados, já expedidos, com três páginas ou mais. Agora também há uma marca (um L branco, que representa o pedido inteiro, com uma aba cor de kraft no canto, sobre fundo petróleo), a fonte Sora nos títulos, cores por função e um tema escuro.
As palavras também mudaram. Situações como "já saiu", "fora da saída" e "vão sair" soavam estranhas, então o pedido agora é simplesmente "expedido", e a caixa de cada pedido virou "Expedir". O nome vem da mesma palavra: "Exped", de expedir, que também se lê em inglês, mais o L do ZPL e do símbolo.
Segunda: lançar a 1.0.0
A segunda foi para transformar um projeto em algo que outras pessoas podem baixar. Entrou a parte legal: Termos de Uso e Política de Privacidade, aceitos na primeira abertura. O gerador sintético aprendeu a desenhar texto de verdade, com um pequeno rasterizador de fontes, para o OCR ter o que ler nos testes. Com a Sora, ele confundia 1, l e I. Com a Arial do Windows, as leituras ficaram no nível das etiquetas reais.
A CI no GitHub Actions agora roda num Windows limpo a cada pull request: restaurar com as versões travadas, compilar, testar e publicar. O repositório do código é privado, então cada versão é copiada para um repositório público que só guarda os downloads, com um changelog escrito para quem usa o app. A CI reprova uma versão sem changelog.
A versão 1.0.0 saiu às 17h07 de segunda, 28 de setembro: um executável único de 62 MB com o .NET dentro, para Windows 10 e 11. Contando do primeiro commit, no sábado à tarde, foram uns dois dias. Até ali eram 482 testes automatizados, 74 decisões registradas e umas 25 mil linhas de C# e XAML, somando o app, os testes e as ferramentas.
Ainda não testado
Por enquanto, não foi testado de verdade. Nenhuma etiqueta do app passou por uma impressora térmica ou por um leitor de código de barras, e ele ainda não foi usado num dia real de expedição. Todos os números de legibilidade acima são digitais, e uma leitura digital é mais tolerante que uma física. Meu amigo viu o app funcionando e confirmou que ele resolve o problema.
Há lacunas menores também. O OCR depende do recurso de OCR em português do Windows, que uma instalação limpa não traz. Sem ele, ficam indisponíveis o ID do pedido, o roteamento, os itens, a ordenação, a lista de separação e a busca por SKU; importar, conferir e gerar o PDF continuam funcionando. O executável não é assinado. E ninguém comprou ainda.
Próximos passos
São planos, cada um com aquilo de que depende:
- Imprimir numa impressora térmica de verdade e bipar as etiquetas. Isso destrava a letra maior nos itens do checklist (a única coisa que meu amigo pediu além do alinhamento), a conferência da qualidade da etiqueta montada e layouts para outros tamanhos de papel.
- Mostrar o nome e o endereço do destinatário no painel do pedido. O OCR ainda não lê esse bloco, e há uma decisão de LGPD a tomar antes.
- Outros marketplaces. Mapeei três níveis (aceitar qualquer etiqueta de forma genérica, usar o primeiro código de barras como chave do pedido, ou um perfil dedicado para cada marketplace), mas nada começa sem arquivos de amostra reais. Minha suposição sobre o formato da Shopee já deu errado uma vez.
- Assinar o executável quando houver clientes.
O que eu aprendi
Usei o Claude Code como assistente ao longo do caminho, e o projeto correu sem problemas. Onde eu mais melhorei foi em gerenciamento de projeto, arquitetura de software e escrita de prompts.
Se você vende pela Shopee e imprime etiquetas numa térmica 4×6, pode baixar o ExpedL para Windows (todas as versões estão na página do produto). Para testar, me mande um e-mail em contact@gabreusi.dev pedindo uma chave de teste.